GPT-6.1 Solが出たので、いろいろと比較してみた結果Codexの普段使いを「中」に切り替えてみた。
今のところ、これがかなり使いやすい。性能は十分高いし、以前よく使っていたGPT-5.6 Sol「中」より利用枠に余裕があると感じている。
俺はChatGPT Plusで、WordPressの記事作成や下書き投稿、CSS・PHPの修正、ファイル確認などにCodexをかなり頻繁に使っている。そんな使い方で気になるのは、最高スコアよりも「必要な仕事を任せられて、制限で止まりにくいか」だ。
今回は、5.6 Sol中・6 Lunaを使ってきた体験と、6.1 Sol中の第一印象をまとめる。利用枠の比較は筆者の体感であり、同じ入力を使った厳密なベンチマークではない。 公式情報は2026年10月2日時点で確認した内容と分けて紹介する。
結論:普段使いはGPT-6.1 Sol「中」が良さそう
現時点では、俺の用途ならGPT-6.1 Sol「中」を基本にするのが合っていそうだ。Lunaより難しい作業を任せる安心感があり、5.6 Sol中の頃ほど利用枠を気にせず進められている。
記事を書くだけなら、文章が出れば終わりと思うかもしれない。ただ、実際のブログ運営では、素材を確認し、ルールに合わせて本文を作り、複数のファイルを整え、WordPressへ下書き投稿するところまでつながっている。
コード側でも、CSSやPHPの修正、テーマ調整、複数ファイルをまたぐ確認、原因調査、マスタープロンプトや自動化ワークフローの改善を頼む。途中で条件を見落とすと、確認や修正をやり直すことになる。軽さに加えて、一連の作業を任せられる能力が欲しい。
OpenAIの公式更新履歴によると、GPT-6.1 Solは2026年9月29日に公開された。6 Solを更新したモデルで、複雑なコード作業やコンピューター操作、専門的な仕事を、能力とコストのバランスを取りながら扱う位置付けだ。公式更新履歴とモデル仕様で確認できる。
Plusは提供対象に含まれる。利用先はChatGPT WorkとCodexで、通常のChatとは別。表示されるモデルや設定は、クライアントや提供状況によって違うため、自分のモデル選択欄で確認するのが確実だ。公式のモデル案内
「Plusでこれを選べば絶対に制限にかからない」とは言えない。それでも、重いモデルを避けすぎて仕事が進まない状況と、能力は十分なのに枠が尽きる状況の間に、ちょうど良い選択肢が来たと感じている。
5.6 Sol中・Lunaとの体感比較
まず、俺が普段の作業で感じた違いを並べる。ここは公式の性能順位や消費率の表ではなく、筆者の使い方での印象だ。
| モデル・推論設定 | 性能の印象 | 利用枠の印象 | 今の使いどころ |
|---|---|---|---|
| GPT-5.6 Sol「中」 | かなり満足していた | 重い作業が続くと減りが速い | 以前の普段使い |
| GPT-6 Luna「軽」 | 軽い作業に使いやすい | とにかく減りにくい | 定型作業 |
| GPT-6 Luna「高」 | 複雑な判断では能力が欲しい場面も | 高にしてもかなり軽く感じた | 範囲が明確な作業 |
| GPT-6.1 Sol「中」 | Lunaより安心感がある | 想像より余裕がある | 現在の普段使い |
5.6 Sol中は、性能そのものにはかなり満足していた。問題は利用枠だった。重い作業を続けると制限へ到達しやすく、まだ頼みたいことがあるのに止まるのが実用上かなり痛かった。
同じような日常の使い方では、5.6 Sol中は今の6.1 Sol中より、およそ2~4倍ほど利用枠の減りが速かった印象がある。 ただし、これは作業条件をそろえて計測した倍率ではない。タスクや会話の長さも違うので、公式仕様や他の人に当てはまる換算値として読まないでほしい。
6 Luna「軽」は、逆に減りにくさにかなり驚いた。その後「高」へ上げても、体感では消費が大きく増えたとは感じなかった。何度も使う軽い作業には、とても魅力がある。
一方で、複雑な判断や原因調査、少し難しい修正では「もう少し能力が欲しい」と感じる場面があった。これが、今回6.1 Solへ移ってみた一番の理由だ。
公式の位置付けでも、6 Lunaは対象が明確な大量・反復作業向けの効率重視モデル、6.1 Solは複雑な作業向けと案内されている。旧5.6世代ではSolが高能力を担うモデルだった。ただ、世代や名前だけで、自分の仕事の成功率まで決まるわけではない。Lunaの仕様、5.6を含むモデルガイド
GPT-6.1 Sol中の利用枠はどれくらい減る?
6.1 Sol中を使っていて最初に感じたのは、「思っていたより減らないな」ということだった。通常の作業では、それほど大きく減らずに使えている。
もちろん、消費が小さい作業ばかりではない。長時間の推論や長考が入る重い処理では、5時間枠の表示が一度に10~20%程度減ることがある。 この数字も筆者の使用中に見た残量変化で、全タスク共通の消費率ではない。
重い処理を何度も続ければ、6.1 Sol中でも枠は尽きる。それでも、以前の5.6 Sol中より明らかに余裕を感じている。性能に満足しながら、次の仕事を頼みやすいのが良い。
OpenAIの料金・利用枠案内には、Plusのローカルメッセージについて、5時間あたり6.1 Solが15~160、6 Solが15~150、6 Lunaが350~3,000という目安が載っている。これは固定の送信回数ではない。 幅が大きいこと自体が、モデルと作業によって消費が変わることを示している。公式の利用枠案内
この目安は「6.1 Sol中なら必ず160回使える」という意味でも、俺の2~4倍という印象を証明するデータでもない。ローカルとクラウドでも消費は変わり、同じモデルであっても入力・出力量、保持する文脈、推論やツールの使い方などが影響する。
API料金を調べるとモデル間の価格差も分かるが、それをPlusの残量へそのまま換算はできない。APIのトークン料金と、Plusに含まれるCodex利用枠は別の仕組みだ。俺が「バランスが良い」と感じているのは、日常の作業を進めたときの能力と残量の組み合わせについてだ。
5時間枠と1週間枠は「使える時間」ではない
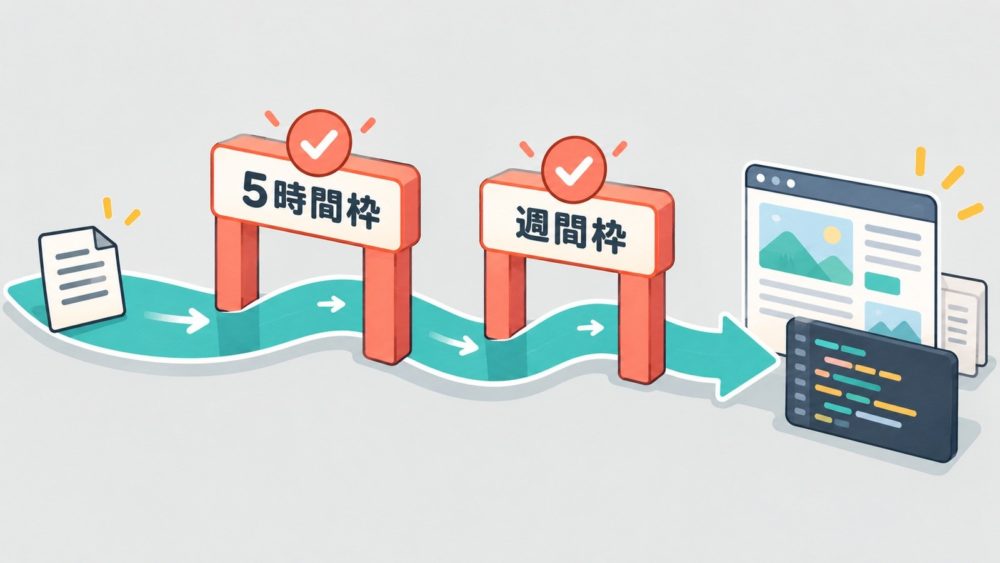
俺のPlus環境では、5時間枠と1週間枠の両方を確認する必要がある。追加クレジットなどを使わず、プランに含まれる範囲で次の作業を始めるなら、片方だけ残っていても足りない。
ここで紛らわしいのが「5時間」という名前だ。これは、PCの前で5時間作業できる権利を表しているわけではない。一定の期間に使える量を管理する枠で、軽い依頼と長い原因調査が同じ量を消費するとは限らない。
公式ヘルプでも、消費はモデル、実行場所、作業の複雑さ、文脈、推論、速度設定、ツールなどによって変わると説明されている。複数工程を続ける依頼や、長い文脈を扱う作業では、短い依頼より大きく使うことがある。CodexとChatGPTプランの公式ヘルプ
以前の利用では、5時間枠をおおよそ5回ほど使ったあたりで、週間枠を使い切った経験がある。ただし、「週間枠=5時間×5=25時間」という意味ではない。 そのときのモデルや作業量で、結果としてそうなっただけだ。
今回確認した公式資料では、5時間枠と週間枠の正式な内部容量や、「5時間枠何回分が週間枠になる」という固定換算値は確認できなかった。表示の割合から容量を逆算して、仕様として数値化することもしない。
公式案内では、ローカルとクラウドの利用量を共有し、週間制限が適用される場合もあるとしている。Workなど対象機能と枠を共有する場合もあるので、Codexだけの作業履歴を見ても、すべての消費を説明できるとは限らない。
制限が近いときは、利用状況画面でどの枠が減っているか、いつリセットされるかを見る。CLIなら/statusでも確認できる。また、最新ヘルプでは、進行中のターンは制限到達後も一定条件で継続できるとしている。昔の「止まった」という体験と、今のすべての場面の動作は分けて考えたい。
Lunaを極高にせず6.1 Solへ移った理由
Lunaの利用枠が軽いなら、推論設定をさらに上げれば良いのでは、とも考えた。ただ、当時見た公開ベンチマークでは、極高へ推論量を増やした割にスコアの伸びが小さく見えた。そのため、今回はLuna「極高」を積極的に常用テストしていない。
これは筆者のグラフの読み取りと選択理由だ。「Lunaは極高にしても伸びない」と公式が保証しているわけではない。 今回確認できた公式本文だけでは、Luna高と極高の全評価について、差を一律に数値化できない。評価ごとの違いもあるので、「極高は無駄」とは言えない。
実際、Luna自体は低能力なモデルではない。公式発表では、DeepSWE v1.1でLunaのmax設定は66.6%としている。maxは極高とは別の設定なので、この数値を「Luna極高の成績」として扱わない。GPT-6 Sol・Lunaの公式発表
一方、6.1 Solの公式評価には、モデルを変える意味を考える材料がある。DeepSWE v1.1は実際のコードベースで長いソフトウェア開発タスクを解く評価で、6.1 Solは6 Solの最高成績を、より低い推論設定で6.4ポイント上回ったと報告されている。
複数工程の仕事を見るAutomationBench 1.0.6でも、6.1 Sol「中」は6 Sol「中」より4.8ポイント高い。コードだけでなく、ツールを使って一連の仕事を終える能力にも改善があるという公式結果だ。GPT-6.1 Solの公式発表
ただし、このDeepSWEの差を、そのまま「中同士の差」と読むことはできない。公式評価は研究環境やAPIで行われており、俺のWordPress運営での成功率やPlusの消費量も直接示さない。ベンチマークは選ぶ材料として見て、最後は自分の作業で確認する。
推論量は「どれだけ考えるか」、モデルは「どのモデルに考えてもらうか」の違いだ。公式ドキュメントでも、高い推論設定は品質を改善し得る一方、待ち時間やトークン量が増えると説明されている。設定を上げた分だけ、必ず比例して性能が伸びるとは限らない。公式の推論設定案内
俺の場合は、Luna高で軽さを実感しつつ、複雑な仕事にはもう少し能力が欲しかった。そこからLunaの推論量をさらに増やすより、6.1 Solへ変えて「中」で使う方が、今のところしっくり来ている。
現時点の使い分けと、今後確かめたいこと
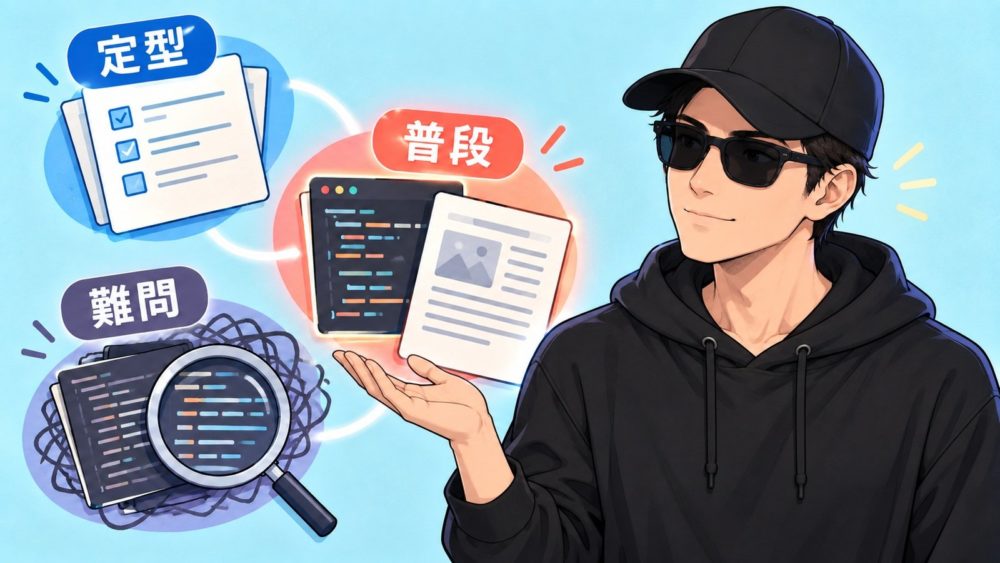
今は、仕事の難しさと範囲に合わせて選ぶ方向が合いそうだ。普段は6.1 Sol中を使い、軽い定型作業をLunaへ、本当に難しい調査は必要に応じて6.1 Solの高い推論設定へ、という分け方になる予定。
| 作業 | 筆者が現時点で選びたい設定 | 判断の目安 |
|---|---|---|
| 軽い定型作業 | GPT-6 Luna | 手順と対象が明確な確認・整形など |
| 普段のCodex作業 | GPT-6.1 Sol「中」 | 記事制作、CSS・PHP修正、複数ファイルの確認など |
| 本当に難しい原因調査 | 必要に応じて6.1 Solの高い推論設定 | 条件が絡み、深い検討が必要なとき |
これは、すべての設定を同じ条件で試し終えた結論ではなく、俺の用途に合わせた暫定的な方針だ。軽い作業が中心ならLunaで十分な人もいるだろうし、毎回かなり難しい仕事を頼む人なら、別の設定が合うかもしれない。
5.6 Sol中に性能面で満足していて、利用枠の減りだけが気になっていた人には、6.1 Sol中を自分の普段の作業で試す意味がありそうだ。逆にLunaで困っていないなら、すべてを切り替える必要は感じない。
今後は、似た作業を頼む前後で5時間枠と週間枠を両方記録し、モデル・推論設定・作業内容・やり直しの有無も残していきたい。今回は使用期間が短く、そろえた比較ログもない。週間枠まで含めた長期の持ちや、難しい調査で推論設定を上げたときの変化は、まだ確かめる余地がある。
PlusでCodexをかなり使う俺にとって、今の6.1 Sol「中」は、必要な能力を確保しながら日常的に使いやすい設定だと感じている。制限を気にして能力を落としすぎる前に、まず普段の仕事でこのバランスを見てみるのは良いと思う。
 3キーのマクロキーボードをAIで魔改造!SwitchBotもモニターもノブ1つで操作
 MoonlightとVDDをAIで快適化|非プログラマーがWindows用モニター切替ツールを作るまで
 AIってみんな何に使ってる?俺のChatGPT活用法とこれからやってみたいこと
 SwitchBotをWindowsタスクバーにまとめてみた|1つのアイコンから照明・カーテン・換気扇を操作